Usa SQL quando precisares
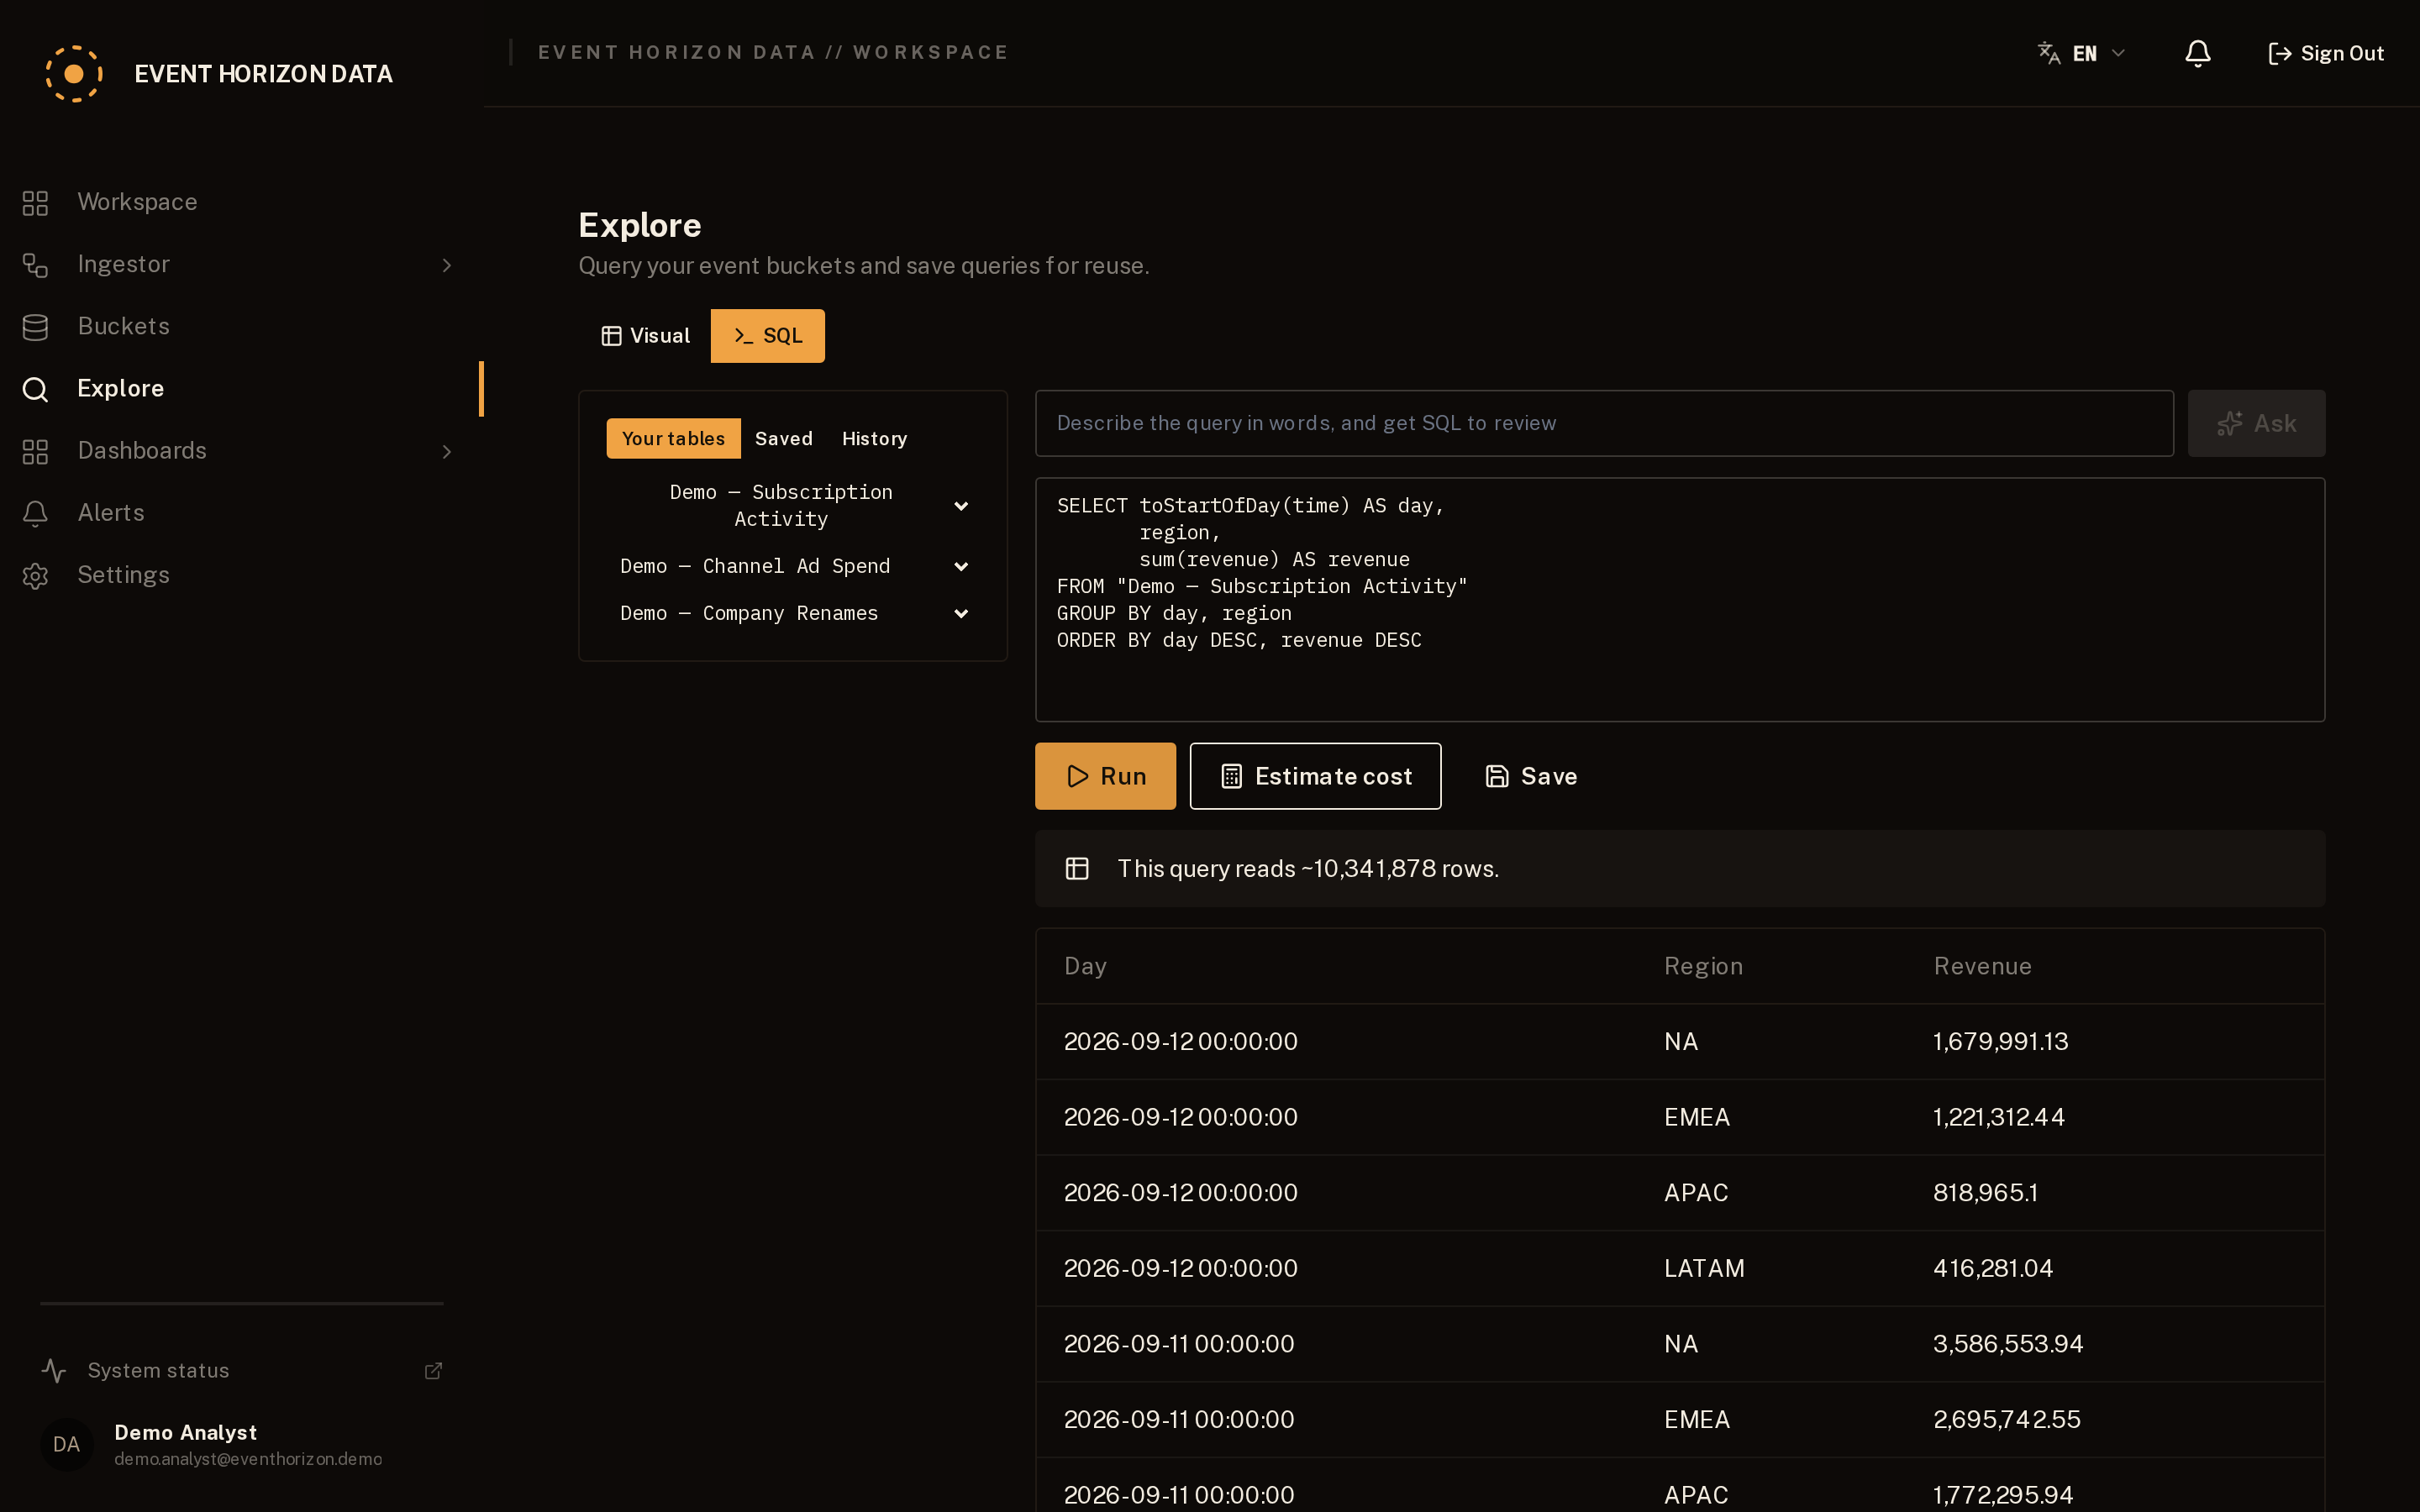
Quando a interface visual não chega, usa a interface SQL. As consultas são validadas, limitadas ao teu tenant e têm o custo verificado antes de correrem.
Guarda as consultas úteis como widgets de dashboard. Liga Python, R ou Jupyter quando o teu trabalho precisar de um notebook.
A maioria das perguntas nunca precisa de SQL, mas quando o quiseres, o Explore tem um separador SQL. Escreves SQL normal contra os teus buckets de eventos como se cada um fosse uma tabela, sem veres como o warehouse os guarda por baixo. A tua query é validada e reconstruída do nosso lado, trancada à tua organização, por isso só consegue ler os teus próprios dados.
Toda a query é orçamentada antes de correr, à maneira do dry-run do BigQuery: uma que leria mais do que o teu plano permite é recusada à cabeça, com a estimativa à frente, para uma query pesada falhar depressa em vez de gerar fatura. Grava uma query de que gostes e larga-a num dashboard como widget.
Para consultar a partir de um notebook, gera um token em Definições → Tokens de API e envia SQL para o endpoint de dados a partir de Python, R ou Jupyter. O tenant vem do token, por isso um token só consegue alcançar os dados da sua própria organização:
curl -X POST "https://eventhorizondata.com/api/v1/data/sql" \
  -H "Authorization: Bearer <token>" \
  -H "Content-Type: application/json" \
  -d '{"sql":"SELECT toStartOfDay(time) AS day, sum(value) AS total FROM orders GROUP BY day ORDER BY day"}'
O token vai no cabeçalho Authorization e pode ser revogado a qualquer momento; um token revogado deixa de funcionar de imediato. A resposta é JSON por omissão, ou CSV com `?format=csv` ou um cabeçalho `Accept: text/csv`. `GET /api/v1/data/schema` lista os buckets que podes consultar.
Envia o teu primeiro evento.
Cria uma conta e passa dos dados em bruto a um dashboard em minutos.